El lanzamiento de Qwen 3.8-27B el 14 de agosto de 2026 ha consolidado un cambio de paradigma histórico en la industria de la inteligencia artificial. Hasta hace muy poco, acceder a capacidades cognitivas avanzadas, razonamiento profundo y análisis multimodal requería pagar costosas suscripciones o tarifas de API a los gigantes de Silicon Valley. Hoy, este modelo denso de 27,8 millardos de parámetros demuestra que el rendimiento de frontera ya no es exclusivo de mega-infraestructuras de nube: ahora puede ejecutarse de forma soberana, privada y gratuita directamente en una sola tarjeta gráfica de consumo.
A diferencia de los modelos más masivos de la serie —como el trillonario Qwen 3.8-Max, sujeto a una licencia comercial restrictiva—, Qwen 3.8-27B se distribuye bajo la licencia permisiva Apache 2.0. Esto permite a desarrolladores, investigadores y empresas su libre descarga, modificación, ajuste fino y despliegue comercial sin techos de facturación ni dependencias externas.
El choque de gigantes: superando a las APIs propietarias de pago
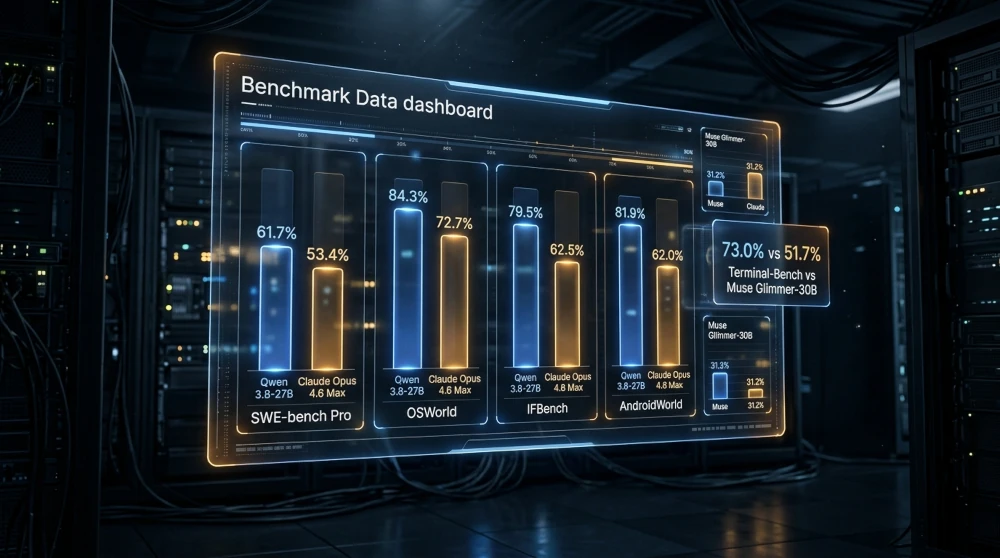
La verdadera hazaña de Qwen 3.8-27B no reside únicamente en su tamaño compacto, sino en su capacidad para superar a modelos propietarios que costaban sumas millonarias de entrenamiento hace apenas unos meses. De acuerdo con las evaluaciones del fabricante, Qwen 3.8-27B supera a Claude Opus 4.6 Max —el modelo insignia de Anthropic de julio de 2026— en 15 de los 19 benchmarks overlapping (una tasa de éxito del 78,9%).
Las métricas en entornos de automatización y desarrollo agéntico son contundentes:
- SWE-bench Pro (Resolución de Bugs Reales en GitHub): Qwen 3.8-27B alcanza un 61,7% de éxito, superando con creces el 53,4% de Claude Opus 4.6 Max. Esto lo posiciona como la herramienta local más potente para ingenieros de software.
- OSWorld-Verified (Uso Autónomo de Sistemas Operativos): en pruebas que exigen controlar un escritorio real mediante clics, archivos y navegación, el modelo registra un espectacular 84,3%, sacándole más de 11 puntos al 72,7% de Claude Opus 4.6 Max.
- IFBench (Cumplimiento de Instrucciones Complejas): en la capacidad de obedecer restricciones sintácticas y de formato sumamente estrictas, Qwen 3.8-27B lidera con un 79,5% frente al 62,5% de Anthropic.
- AndroidWorld (Automatización Móvil): registra un 81,9% de efectividad frente al 62,0% de su competidor cerrado.
Adicionalmente, si se le compara con su competencia directa en pesos abiertos —como Muse Glimmer-30B de Meta—, Qwen 3.8-27B gana absolutamente todas las evaluaciones compartidas. Se impone en Terminal-Bench 2.1 (73,0% vs. 51,7%) y en GPQA Diamond (89,2% vs. 83,5%), demostrando una optimización de parámetros sin precedentes. Aunque sigue por detrás de Opus 4.6 Max en razonamiento enciclopédico puro y preguntas académicas de caja negra —como Humanity’s Last Exam, donde obtiene un 30,8% frente al 40,0%—, su enfoque pragmático lo convierte en el rey indiscutible de las tareas pragmáticas y los flujos agénticos automatizados.
Innovación arquitectónica: ¿cómo logra tanto con tan poco?
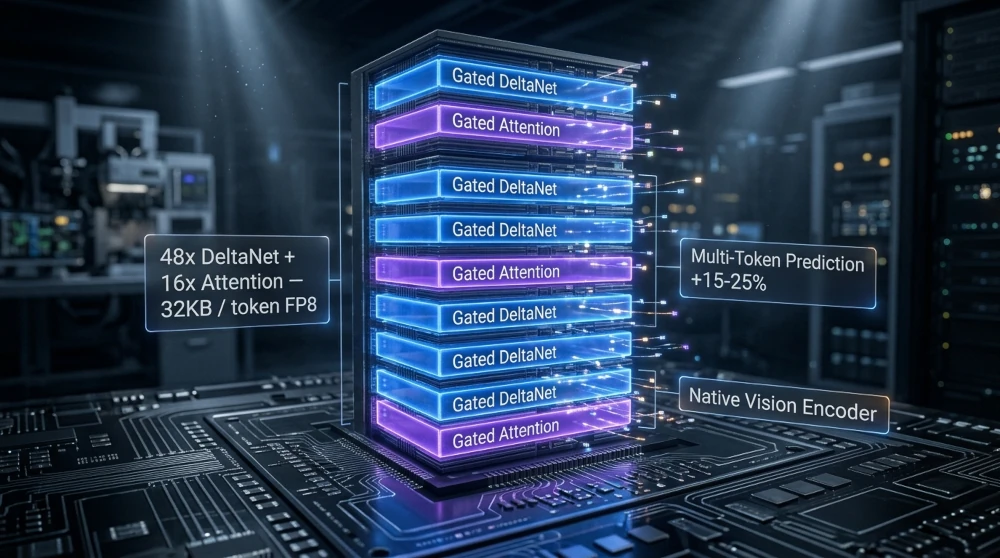
El secreto del extraordinario rendimiento de Qwen 3.8-27B radica en una ingeniería estructural que exprime cada token de memoria mediante tres innovaciones clave:
- Mecanismo de Atención Híbrido (Proporción 3:1): en lugar de utilizar la atención completa clásica de Transformer —cuyo costo crece de forma cuadrática y satura la memoria—, el modelo emplea una topología híbrida. El 75% de sus capas (48 bloques) utiliza atención lineal eficiente (Gated DeltaNet), mientras que el 25% restante (16 bloques) se reserva para la atención tradicional (Gated Attention). Esta combinación reduce de forma dramática el peso dinámico del caché de claves y valores (KV Cache) a unos escasos 32 KB por token en formato FP8.
- Predicción Multi-Token (MTP): Qwen incorpora un cabezal auxiliar entrenado para predecir múltiples tokens futuros de forma simultánea. Esto posibilita la decodificación especulativa durante la inferencia local, incrementando la velocidad entre un 15% y un 25% sin degradación de la precisión.
- Integración Multimodal Nativa: el codificador de visión para procesar imágenes y videos de hasta escala de horas no es un parche o adaptador acoplado externamente (como ocurre en implementaciones tipo LLaVA). Está integrado de forma nativa en el espacio de embeddings del modelo, optimizando radicalmente la latencia y la comprensión visual cruzada.
Flexibilidad en la práctica: de la supercomputación al hogar
A pesar de su inmenso poder analítico, los requisitos de hardware para ejecutar Qwen 3.8-27B son sorprendentemente accesibles gracias a los esfuerzos de cuantización de la comunidad de código abierto, especialmente a través de formatos optimizados como los de Unsloth (Dynamic V3.0):
- Configuración Mínima (~14-16 GB de VRAM): utilizando cuantización de 4 bits (GGUF o AWQ), el modelo completo puede correr de manera cómoda en tarjetas de consumo general de 24 GB VRAM, como una Nvidia RTX 4090, RTX 5080 o en computadoras Apple Mac con memoria unificada de 24 GB o más. Esto brinda velocidades locales de 60 a 90 tokens por segundo.
- Configuración Recomendada (~28 GB de VRAM): en formatos de precisión FP8, el modelo requiere GPUs de nivel profesional o de gama ultra alta, como una Nvidia RTX 5090 (32GB) o RTX Pro 6000 (48GB), ofreciendo un rendimiento sobresaliente en contextos medianos de hasta 32K tokens.
- Precisión Nativa BF16 (~56 GB de VRAM): requiere hardware de servidor dedicado (H100 de 80GB, H200 o RTX Pro 6000 de 96GB) para operar sin pérdida alguna a lo largo de su ventana nativa de 262.144 tokens.
La paradoja del sobrepensamiento y cómo controlarlo
Un aspecto fascinante de la dinámica de inferencia de Qwen es que el modelo es tan analítico que tiende a sobrepensar sus respuestas de manera predeterminada. Esto ocurre porque su nivel de esfuerzo de razonamiento nativo está configurado en xhigh. Si le pides una tarea extremadamente simple, como renombrar una variable, el modelo puede pasar varios segundos analizando internamente decenas de implicaciones arquitectónicas antes de entregarte el cambio básico.
Afortunadamente, para entornos de producción locales, los ingenieros pueden controlar este comportamiento mediante el parámetro reasoning_effort. Ajustar el esfuerzo a medium o low —o apagarlo por completo para tareas rutinarias (enable_thinking: false)— puede disparar la velocidad de procesamiento de 73,4 a 151,2 tokens por segundo en hardware local.
Advertencia técnica: si planeas utilizar la plataforma Ollama, debes tener en cuenta que su motor suele sustituir la plantilla nativa del modelo por una genérica. Al hacer esto, el parámetro de control de razonamiento queda inaccesible, obligando a Qwen a operar permanentemente en su nivel máximo de sobrepensamiento. Para un control total y profesional, se recomienda implementar servidores dedicados mediante herramientas como llama-server, vLLM o SGLang.