El lanzamiento de la serie Qwen 3.8 en agosto de 2026 representa la consolidación definitiva de Alibaba Cloud en el desarrollo de arquitecturas de inteligencia artificial agénticas y de razonamiento profundo. No obstante, para dimensionar su impacto real, es imperativo despejar la confusión que rodea a su nomenclatura: Qwen 3.8 no hace referencia a un modelo compacto de 8 millardos de parámetros —esa designación corresponde al antiguo Qwen3-8B de abril de 2025—. Por el contrario, la serie Qwen 3.8 constituye la octava iteración de la generación 3 y se articula en torno a dos pilares: su modelo insignia trillonario Qwen 3.8-Max (distribuido como pesos abiertos bajo el identificador Qwen3.8-2.4T-A95B) y su variante densa altamente optimizada de 27 millardos de parámetros, Qwen 3.8-27B.
Este hito se inscribe en un complejo escenario de reestructuración corporativa dentro del equipo de Qwen, marcado por la dimisión de su director de división, Lin Junyang, en marzo de 2026. Poco después, el director ejecutivo de Alibaba, Eddie Wu, consolidó todas las operaciones de IA bajo una nueva unidad unificada denominada Alibaba Token Hub. A pesar de los reajustes, la firma aceleró su ciclo de innovación en respuesta directa a competidores como Moonshot AI, que acababa de introducir el modelo Kimi K3.
Hibridación arquitectónica y la paradoja de sobrepensar
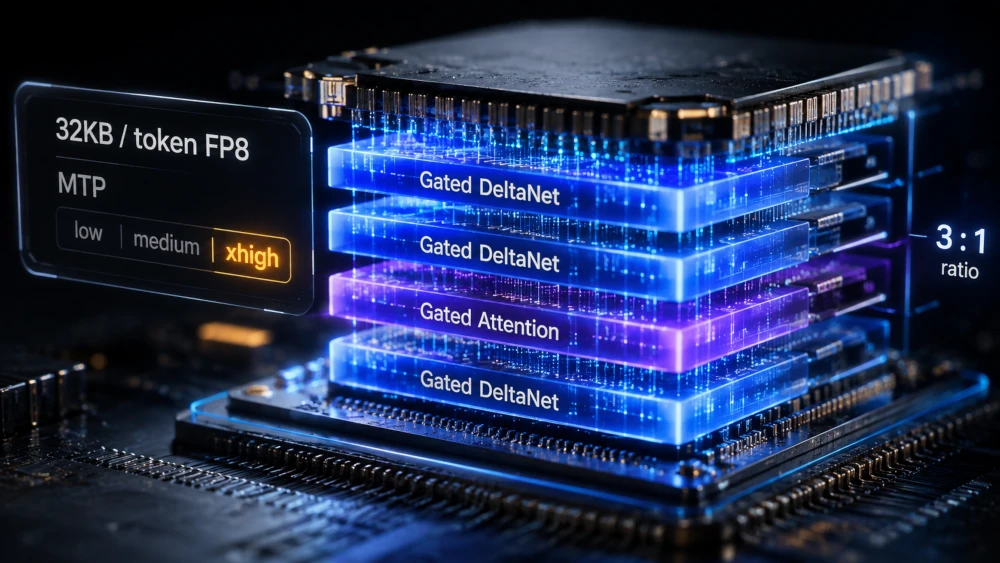
Desde una perspectiva técnica, la familia Qwen 3.8 introduce una hibridación altamente eficiente que optimiza tanto la velocidad de cómputo como la retención de memoria a largo plazo. El núcleo de la innovación radica en una topología híbrida que entrelaza capas de atención lineal (Gated DeltaNet) y capas de atención convencional con softmax (Gated Attention) en una proporción de 3:1.
Dado que la mayor parte del modelo utiliza capas DeltaNet —que operan con un estado recurrente acotado similar a las arquitecturas Mamba o SSM—, el almacenamiento dinámico de tokens en memoria solo se calcula para las capas de atención convencional. Esto disminuye de forma espectacular el peso en VRAM (KV Cache) a aproximadamente 32 KB por token en formato FP8, mitigando la sobrecarga de contextos masivos. El diseño incorpora además la técnica de Predicción Multi-Token (MTP), entrenada en múltiples pasos para acelerar el procesamiento especulativo y mejorar la consistencia sintáctica.
Sin embargo, esta colosal maquinaria de razonamiento viene acompañada de una particularidad operativa que ha desatado intensos debates: el sobrepensamiento sistémico. De manera predeterminada, la serie Qwen 3.8 utiliza el nivel xhigh para el esfuerzo de razonamiento, lo que deriva en análisis abstractos extremadamente extensos ante tareas cotidianas. Por ejemplo, solicitudes básicas de refactorización de código o diseño geométrico en SVG desencadenan reflexiones internas kilométricas en las que el modelo evalúa decenas de posibilidades teóricas antes de emitir la corrección formal.
Para regular este consumo, la API de Qwen Cloud y las implementaciones compatibles exponen el parámetro reasoning_effort con tres configuraciones: low, medium y xhigh. Un aspecto crítico para usuarios locales de Qwen 3.8-27B es que, si se utiliza la plataforma Ollama, el sistema tiende a descartar la plantilla JINJA original y la reemplaza por una genérica, lo que deja inaccesible el interruptor de esfuerzo de razonamiento y fuerza al modelo a operar permanentemente en su nivel máximo de sobrepensamiento.
A esta singularidad se suma una clara segmentación estratégica en su distribución:
- La API de Nube (Qwen 3.8-Max): ofrece procesamiento multimodal completo (imágenes y cuadros de video), soporte para deshabilitar el modo de razonamiento, ventana de contexto por defecto de un millón de tokens y herramientas de búsqueda web integradas.
- Los Pesos Abiertos Trillonarios (Qwen3.8-2.4T-A95B): estrictamente limitados a entrada de texto, ventana nativa de 262.144 tokens y ejecución obligatoria del modo de pensamiento, restringiendo su flexibilidad para interfaces de chat tradicionales.
- La Variante Local (Qwen 3.8-27B): distribuida bajo la licencia permisiva Apache 2.0, sí mantiene la coherencia total con su arquitectura nativa, conservando tanto la codificación de visión de imágenes y video como el interruptor dinámico para activar o desactivar el razonamiento profundo.
Acercándose a la frontera: el choque de gigantes
Las evaluaciones empíricas demuestran que la familia Qwen 3.8 está acortando la distancia con los modelos más avanzados de Occidente a un ritmo sin precedentes, superándolos notablemente en escenarios de automatización agéntica y flujos interactivos de bucle cerrado.
De acuerdo con las métricas oficiales de Alibaba, Qwen 3.8-Max logra hitos sorprendentes frente a Claude Fable 5, Claude Opus 4.8 y GPT-5.6 Sol:
- PaperBench (Reproducción Científica): Qwen 3.8-Max lidera con un espectacular 93,0% de éxito en la reproducción autónoma de experimentos científicos a partir de sus especificaciones impresas, superando a GPT-5.6 Sol (90,5%), Claude Fable 5 (88,8%) y Claude Opus 4.8 (80,3%).
- OSWorld-Verified (Automatización de Escritorio): en tareas de interacción directa con sistemas operativos en tiempo real, Qwen 3.8-Max alcanza el primer lugar con un 86,1%, superando a Fable 5 (85,0%) y a GPT-5.6 Sol (83,2%). La variante local Qwen 3.8-27B alcanza un 84,3%, aventajando ampliamente al anterior buque insignia de Anthropic, Claude Opus 4.6 Max (72,7%).
- IFBench (Cumplimiento de Restricciones): el modelo trillonario destaca con un 82,8% en consistencia y apego sintáctico a formatos e instrucciones específicas, frente al 72,7% de GPT-5.6 Sol y porcentajes inferiores al 64% para la línea Claude.
Sin embargo, las debilidades se hacen evidentes en evaluaciones de caja negra que miden conocimientos generales exentos de contaminación de entrenamiento. En Humanity’s Last Exam (HLE), Qwen 3.8-Max cae al último puesto de los cuatro grandes modelos de frontera con un 43,6%, frente al 53,3% de Claude Fable 5 y el 47,2% de GPT-5.6 Sol. De igual modo, en SWE-bench Pro —resolución de problemas reales de ingeniería en GitHub—, Qwen 3.8-Max se queda en un 67,7%, doce puntos por detrás del contundente 80,0% de Claude Fable 5.
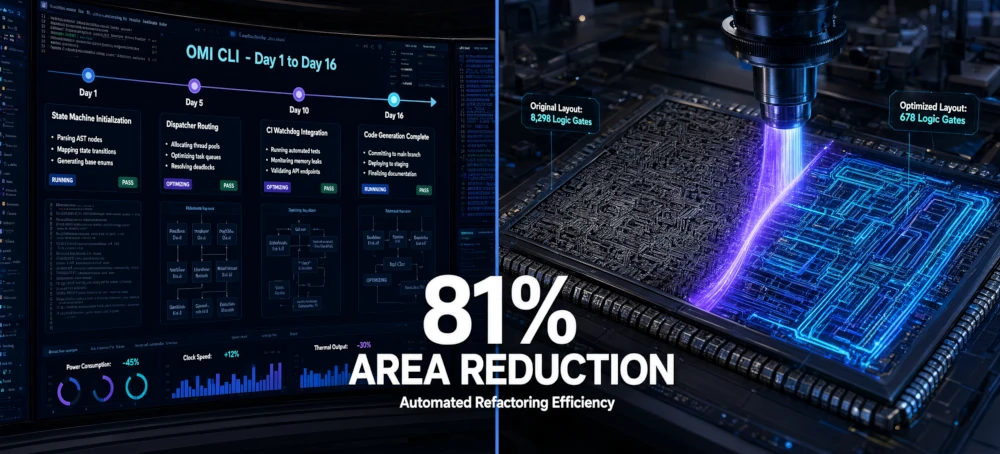
Para compensar estas brechas en retención académica pura, Alibaba ha orientado el potencial de Qwen hacia la resolución de problemas de ingeniería complejos en flujos continuos. Un ejemplo emblemático es el proyecto OMI CLI, donde el modelo recibió un repositorio vacío y trabajó de forma totalmente autónoma durante 16 días, autogestionando la creación de máquinas de estados, dispatchers, watchdogs y loops de CI basados en la corrección iterativa de issues. Igualmente, en pruebas de diseño de hardware criptográfico, Qwen optimizó un circuito integrado congestionado de 8.298 compuertas lógicas reduciéndolo a tan solo 678 tras 500 iteraciones, lo que supuso una reducción física del 81% en el área del chip sin alterar sus funciones.
Geopolítica de la IA: el papel de la estrategia china
La vertiginosa velocidad con la que los modelos chinos han alcanzado la frontera no es casual. El U.S.-China Economic and Security Review Commission analizó detalladamente la estrategia del país asiático.
De acuerdo con el organismo estadounidense, la aproximación china de promover agresivamente el desarrollo de modelos de código abierto —o pesos abiertos—, como la familia Qwen, ha sido un elemento crítico y planificado para superar las restricciones de Occidente en capacidad de cómputo (bloqueo de chips y hardware avanzado).
Este fomento le permite a China:
- Optimizar el cómputo colectivo: evadir las limitaciones de hardware impulsando a toda la comunidad industrial y académica a refinar, cuantizar y desplegar arquitecturas locales altamente eficientes sin infraestructura de nube estadounidense.
- Perfeccionar la curación de datos reales: superar los cuellos de botella de datos sintéticos mediante la recopilación masiva de datos en entornos locales distribuidos.
- Integración en la economía real: facilitar la inyección directa de estas tecnologías en sectores estratégicos como la robótica, la manufactura avanzada y la investigación científica.
En este contexto, la ingeniería china se ha enfocado en maximizar el rendimiento por dólar de silicio gastado. Mientras que los laboratorios occidentales invierten sumas astronómicas entrenando modelos densos cada vez más masivos, Alibaba ha perfeccionado la optimización mediante MoE. Qwen 3.8-Max utiliza una arquitectura de 2,4 billones de parámetros, pero solo activa 95 millardos de parámetros por token durante la inferencia. Esta eficiencia le permite irrumpir en el mercado con tarifas extremadamente competitivas de 2 USD por millón de tokens de entrada y 6 USD por millón de tokens de salida, una fracción del costo de competidores como Claude Fable 5 (10 USD / 50 USD) o GPT-5.6 Sol (5 USD / 30 USD).
En definitiva, la serie Qwen 3.8 reescribe las reglas del juego de los pesos abiertos agénticos. Al forzar un diseño enfocado en el pragmatismo computacional, la IA china no solo elude las barreras geoeconómicas del hardware, sino que propone una alternativa sumamente competitiva y soberana para el ecosistema global de desarrollo.